#FastAPI
#第一章.协程
#1.协程的介绍
1.概述:在一个线程中,当这个线程等待的时候,内部还可以干其他的事儿的技术,就叫做协程,也叫做微线程#2.线程处理IO密集操作的不足
1.切换开销大:在操作系统中CPU会在多个线程之间做切换,需要耗费大量的CPU时间  -> 因为要来回切换
2.同步复杂:多个线程之间操作同一个数据,很有可能出现线程不安全的问题,虽然加锁好使,但是加锁就很容易出现死锁的问题
3.阻塞浪费:一个线程执行到网络等待时,它会被阻塞,虽然操作系统会切换到另外一个线程执行,但是线程自身的切换成本依然很高,所以往往并无法创建足够多的线程来应对极高的并发量#3.协程的优势
1.调度方式:不是由CPU调度,是有程序自己来确定的
2.创建成本低:在一个线程中,咱们自己想搞多少个协程就搞多少个协程,我们直接定义协程函数即可
3.没有锁的机制:同一个时间只有一个协程执行,不需要锁保护共享的资源
4.开销低:不需要频繁创建,销毁,切换,只需要极小的函数调用,在处理高并发的时候效率更高#第二章.协程的使用
#1.async和await
通过async 和 await来实现协程程序#1.1.定义协程函数:async def
1.格式:
  async def 方法名():
      方法体
2.返回值:返回的是一个协程对象,虽然我们没有写return,但是协程函数也会自动返回协程对象

3.注意:如果想让当前协程挂起,让别的协程执行,需要使用await
import asyncio
async def method():
print("协程方法开始执行")
#模拟一个耗时操作,让当前协程挂起,此时其他协程可以执行
await asyncio.sleep(2)
print("协程方法结束")
if __name__ == '__main__':
#调用method方法,得到一个协程对象
res = method()
#真正执行协程
asyncio.run(res)1.注意:await是协程的灵魂,它用于暂停当前协程的执行,并等待一个可等待对象(Awaitable,通常是另一个协程或I/O操作)完成。
a.遇到await时:当前协程进入“挂起”状态。
b.事件循环(EventLoop)接管:它会去调度执行其他处于“就绪”状态的协程。
c.等待对象完成后:事件循环会把控制权交还给被挂起的协程,使其从await之后继续执行。
#1.2.运行协程:事件循环
1.概述:事件循环是管理和调度所有协程的核心机制,负责安排哪个协程先跑,哪个协程等待,哪个协程继续跑
2.作用:
  a.接收协程任务
  b.执行协程
  c.遇到await等待时,先去执行别的协程
  d.等待结束后,再回来继续执行
3.如何运行协程?
  asyncio.run(协程对象)  -> 创建事件循环  + 运行协程  + 结束后关闭

4.实现
  a.定义两个协程函数,设置每个协程要执行的任务
  b.定义一个主协程函数,将两个协程包装成后台任务,统一调度
  c.定义程序入口,启动协程事件循环
import asyncio
async def method01():
print("协程方法method01开始执行")
# 模拟一个耗时操作,让当前协程挂起,此时其他协程可以执行
await asyncio.sleep(2)
print("协程方法method01结束")
async def method02():
print("协程方法method02开始执行")
# 模拟一个耗时操作,让当前协程挂起,此时其他协程可以执行
await asyncio.sleep(2)
print("协程方法method02结束")
#定义一个主协程,做统一调度
async def main():
# 创建并发任务
task01 = asyncio.create_task(method01())
task02 = asyncio.create_task(method02())
# 等待所有任务完成,在执行主协程下面的代码
await task01
await task02
if __name__ == '__main__':
# 调用main函数,启动协程
asyncio.run(main())#第三章.WSGI和ASGI
1.概述:WSGI和ASGI是python web开发中的两个重要的接口规范,用于定义web服务器与python web应用之间的通信规则,他们的核心区别在于对异步的支持能力

  a.WSGI:Web Server Gateway Interface(Web 服务器网关接口)
b.ASGI:Asynchronous Server Gateway Interface(异步服务器网关接口)#1.核心定位与目标
1.WSGI:Python 最早的 Web 服务器与应用接口规范(2003 年提出),仅支持同步操作,主要解决早期 Python Web 框架(如 Flask、Django 旧版本)与服务器的兼容性问题,让同一应用可以运行在不同的 WSGI 服务器上(如 Gunicorn、uWSGI)

2.ASGI:是 WSGI 的异步升级版(2018 年提出),原生支持异步操作,同时兼容 WSGI。设计目标是解决 WSGI 无法高效处理异步任务(如 WebSocket、长轮询)的问题,为 FastAPI、Starlette 等异步框架提供标准接口#2.通过流程差异
1.WSGI:
  客户端发送请求 → WSGI 服务器接收 → 同步调用应用的 application(environ, start_response) 函数 → 应用处理后通过 start_response 返回响应 → 服务器转发响应。
整个过程是同步阻塞的,一个请求未处理完时,对应的线程 / 进程无法处理其他请求。


2.ASGI:
客户端发送请求 → ASGI 服务器接收 → 将请求封装为事件(如 http.request) → 通过事件循环异步传递给应用 → 应用处理后返回事件(如 http.response) → 服务器转发响应。等待 I/O 操作(如数据库查询)时,事件循环会切换到其他请求,实现非阻塞处理#3.WSGI和ASGI怎么选择
若使用同步框架(如 Flask、Django 3.0 之前版本),需用WSGI服务器(如 Gunicorn)。
若使用异步框架(如 FastAPI、Starlette、Django 3.1+ 异步模式),需用ASGI服务器(如Uvicorn)以发挥异步性能。
对于需要实时通信(如WebSocket聊天、实时数据推送)的场景,必须使用ASGI。

现在开发,服务器肯定都是异步处理请求的,所以我们选择的服务器是 Uvicorn(基于ASGI标准的服务器)#第四章.FastAPI框架
#1.FastAPI框架介绍
1.概述:FastAPI 是一个现代、快速(高性能)的Web框架,用于构建web应用程序。是建立在Starlette 和Pydantic基础上的。它基于Python 3.7 +的类型提示(type hints)和异步编程(asyncio)能力,使得代码易于编写、阅读和维护。FastAPI 具有自动交互式文档(基于 OpenAPI 规范和 JSON Schema)、数据验证、依赖注入(Dependency Injection)等功能,这些功能使得开发速度更快、更可靠。

2.资料网址:
  a.文档: https://fastapi.tiangolo.com
  b.源码: https://github.com/fastapi/fastapi

3.作用:
  a.接收HTTP请求(GET,POST请求等)
  b.处理请求参数
  c.执行业务逻辑
  d.返回JSON数据给客户端 -> 轻量级的客户端和服务端之间的交互数据
    {key:value,key:value}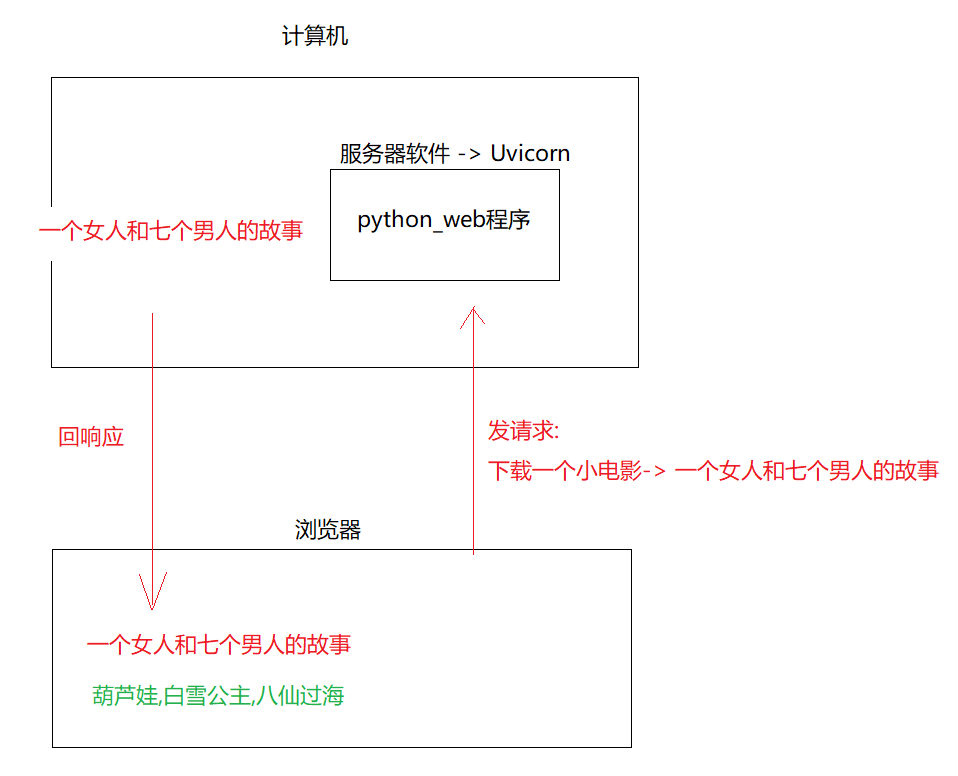
#2.入门程序
#2.1.创建新项目
#2.2.安装依赖
1.pip install fastapi
2.pip install uvicorn#2.3.代码实现
1.使用FastAPI()创建FastAPI对象
2.使用@app.get("请求路径")接收对下面的协程函数发过来的请求
3.在协程函数中做业务处理,然后使用return来给客户端回响应
from fastapi import FastAPI
#创建FastAPI对象
app = FastAPI()
@app.get("/")
async def request_method01():
return {"message":"hello fastapi"}
@app.get("/items/{item_id}")
async def request_method02(item_id:int,param:str = None):
return {"item_id":item_id,"param":param}#2.4.启动服务
#2.4.1.通过命令启动
1.打开pycharm上的终端

2.进入到当前python代码所在的目录

3.输入命令:uvicorn py文件名:FastAPI实例名称 --reload
  uvicorn demo01_fastapi:app --reload

4.浏览器输入访问路径 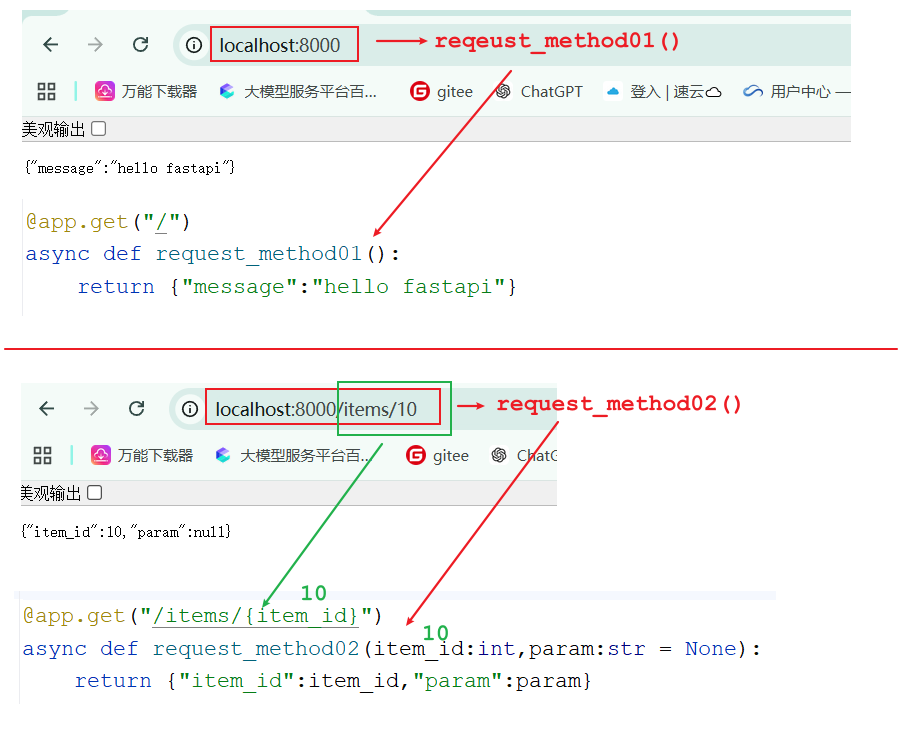
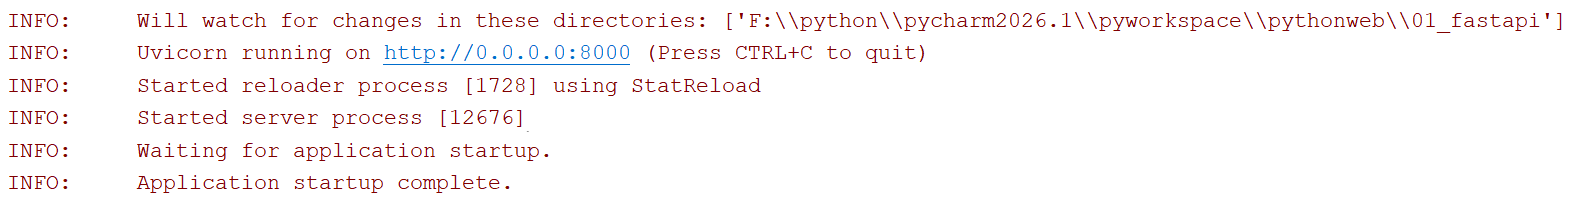
#2.4.2.通过程序启动uvicorn服务
import uvicorn
from fastapi import FastAPI
#创建FastAPI对象
app = FastAPI()

@app.get("/")
async def request_method01():
    return {"message2222":"hello fastapi"}

if __name__ == '__main__':
    uvicorn.run(
        app="demo02_fastapi:app",
        host="0.0.0.0",
        port=8000,
        reload=True #代码修改后自动重启
    )
#2.5.程序说明
1.程序说明:程序启动之后FastAPI底层会创建一个字典:
  key:请求路径
  value:对应的方法名

2.当我们在浏览器上访问,填写路径时,FastAPI会获取路径,将其当做key,去找对应的value,这个value就是方法名,然后调用该方法

3.如果@app.get("/items/{item_id}")有请求参数了,那么方法的参数名要和这个请求参数名字一样,这样浏览器上的请求参数才能给该方法的参数赋上值


4.如果定义方法的时候前面没有加async,FastAPI在处理请求的时候就按照同步请求处理;加上了async,FastAPI就按照异步请求处理

5.想给客户端响应什么内容,就可以用return返回什么内容#3.交互式API文档
1.作用:
  a.可以看清服务器能接收哪些请求
  b.操作请求参数,传递请求参数
2.打开方式:
  浏览器输入: localhost:8000/docs

3.发请求,测接口还可以使用其他软件:
  a.postman
  b.apipost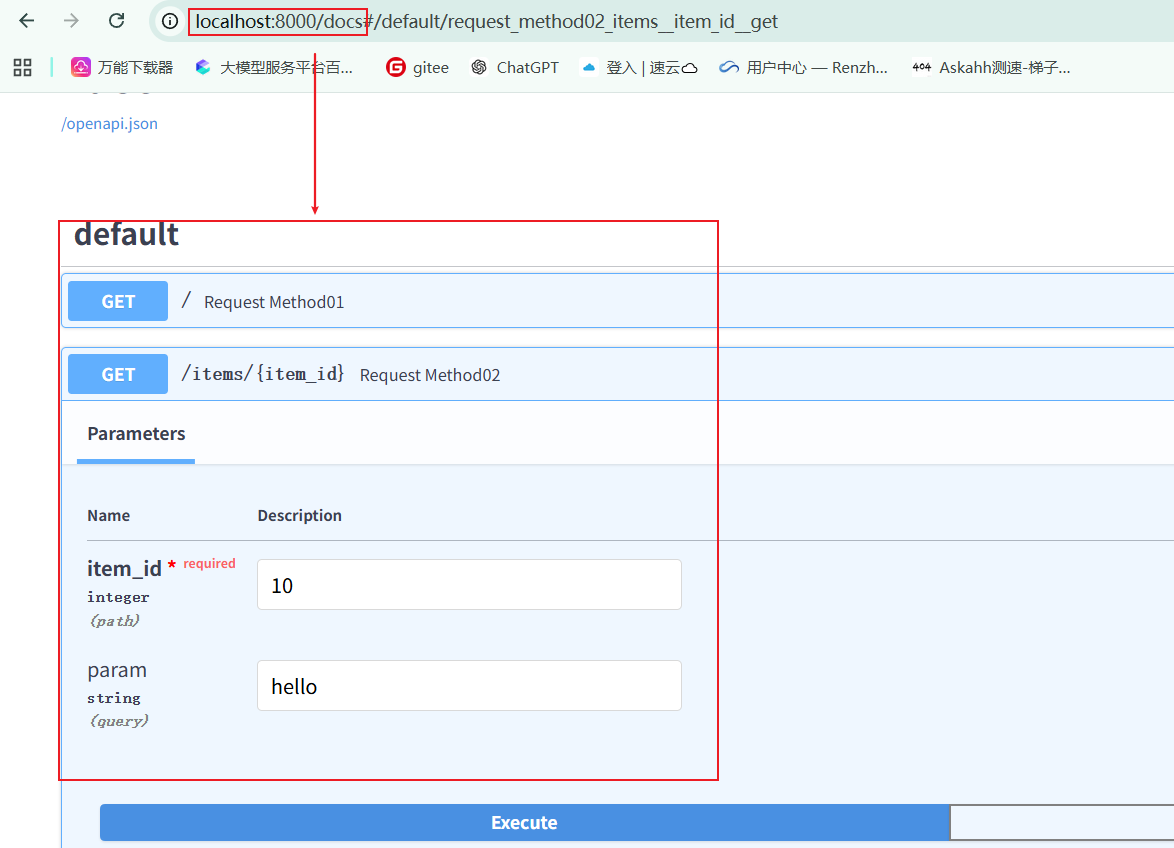
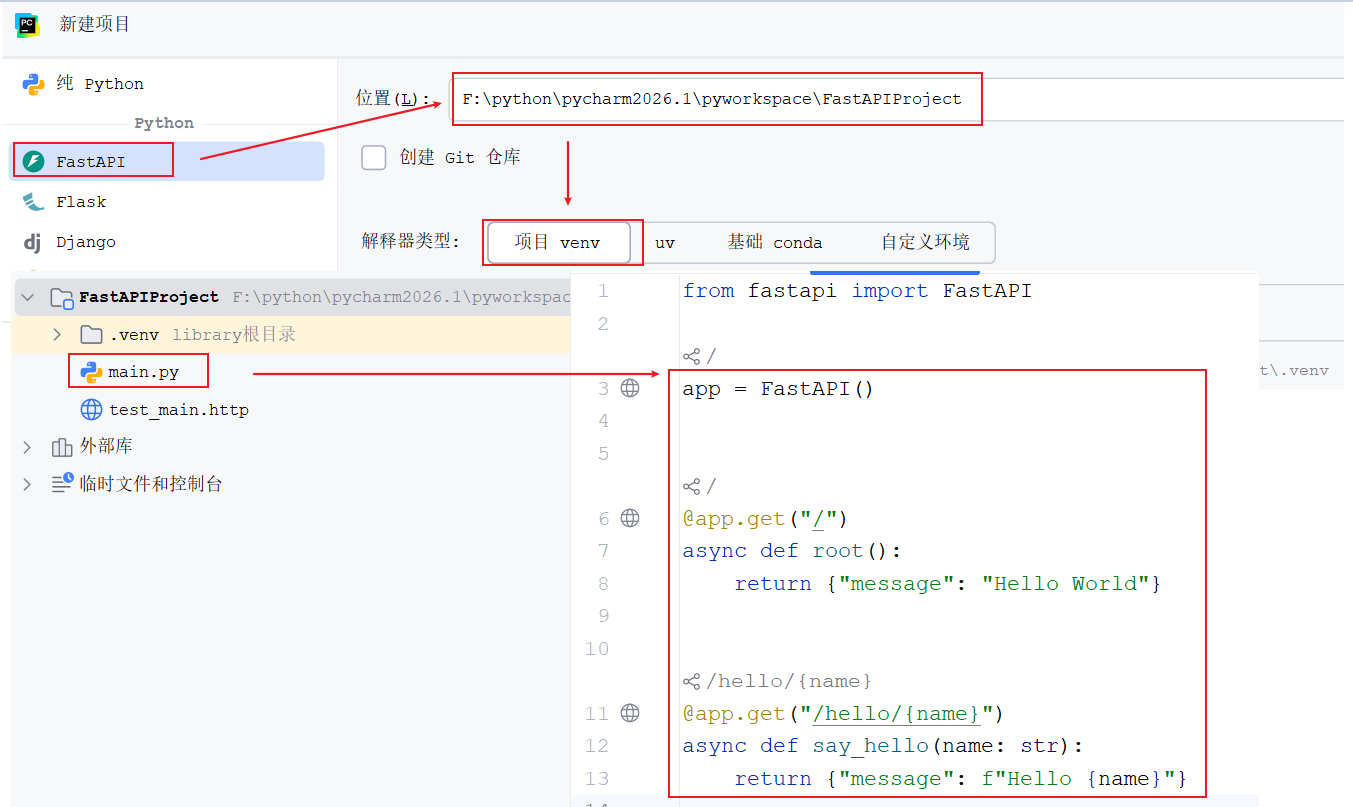
#4.通过pycharm创建FastAPI工程
#5.FastAPI程序详解
#5.1.请求行为_@app.get
1.概述:服务器根据客户端发来的 HTTP 方法,决定由哪段代码来处理这次请求 的机制
2.格式:@app.get("请求路径")
3.请求行为:我们用@app.xxx来告诉服务器我们要做什么操作
  get:查询-> 浏览器地址栏发送请求默认为get请求
  post:添加
  put:修改
  delete:删除
4.比如:
  @app.get("请求路径") -> 告诉服务器,我们的请求路径是什么,然后这个请求发送过来之后,我们做查询操作
from fastapi import FastAPI
app = FastAPI()
# 查询
@app.get("/users/{user_id}")
def get_user(user_id: int):
return {"id": user_id, "name": "tom"}
@app.post("/users") # 添加
def create_user(username: str, password: str):
return {"msg": "添加成功", "username": username}
@app.put("/users/{user_id}") # 修改
def update_user(user_id: int, username: str):
return {"msg": "修改成功", "id": user_id}
@app.delete("/users/{user_id}") # 删除
def delete_user(user_id: int):
return {"msg": "删除成功", "id": user_id}#5.2.路径参数
1.概述:请求路径上携带的数据
2.格式:
  @app.get("/items/{item_id}")其中{item_id}就是路径参数
3.如何传值:直接在请求路径上为其传值
localhost:8000/items/10#5.2.1.路径参数声明类型以及类型转换
1.声明类型:直接在方法参数后面加     :数据类型
  @app.get("/items/{item_id}")
  async def request_method02(item_id: int):
    return {"item_id": item_id}
2.注意:
  我们在客户端发送请求时,请求路径上的路径参数一概都是以字符串传递,但是请求发送到服务端之后FastAPI会将字符串自动转成我们自己定的类型
  但是传递过来的路径参数要能正确转型,比如:item_id为int型,那么我们传递的路径参数必须是数字形式,要是传递aa过来肯定报错

如果不指定类型,默认都按照字符串处理 #5.2.2.路径参数顺序
注意:路径操作是按顺序依次运行的 -> 从上到下import uvicorn
from fastapi import FastAPI
app = FastAPI()
@app.get("/items/main")
async def request_method02():
return {"main":"main"}
@app.get("/items/{item_id}")
async def request_method01(item_id):
return {"item_id":item_id}
if __name__ == '__main__':
uvicorn.run(
app="demo03_fastapi:app",
host="0.0.0.0",
port=8000,
reload=True #代码修改后自动重启
)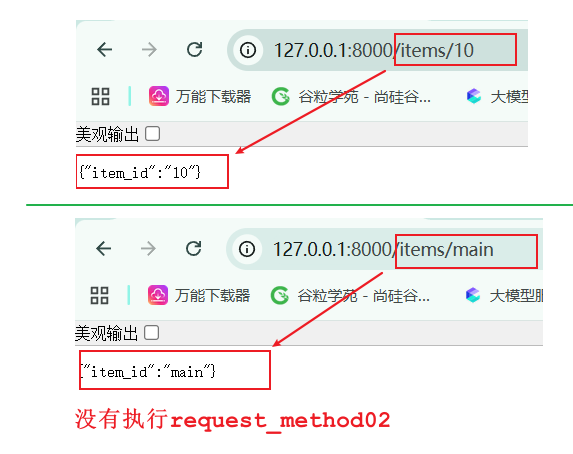
1.问题分析:
  1.request_method1方法中的路径参数没有规定具体的类型,所以服务端的FastAPI直接按照字符串类型处理路径参数,所以我们传递10以及main都直接被request_method1接收了,就没有走request_method2

2.解决:
将写死的路径放到上面#5.3.请求参数
#5.3.1.请求参数介绍
1.概述:请求中携带的数据
2.格式:
  请求路径?请求参数
3.注意:
  a.请求参数都是在?后面
  b.请求参数都是key=value形式
  c.多个请求参数之间用&连接  -> key=value&key=value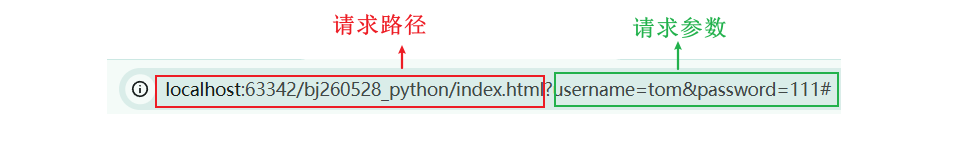
#5.3.2.请求参数定义
1.定义格式:
  直接在方法中定义参数即可
2.注意:
  参数位置如果写了 请求参数名:数据类型 = None
  此时在发请求时,这个请求参数可以不赋值,也可以赋值;但是如果没有= None,那么在发请求的时候必须为这个请求参数赋值
import uvicorn
from fastapi import FastAPI
app = FastAPI()
@app.get("/items")
async def request_method01(param1:str = None,param2:str = None):
return {"param1":param1,"param2":param2}
if __name__ == '__main__':
uvicorn.run(
app="demo04_fastapi:app",
host="0.0.0.0",
port=8000,
reload=True #代码修改后自动重启
)
#5.3.3.请求参数匹配方式
1.方式1:默认值: -> 直接在方法参数上给参数赋值
2.使用:访问路径上不用专门写请求参数
============================================================================
@app.get("/items/")
async def request_method01(param1: str = "tom",param2: str = "jack"):
  return {"param1": param1, "param2": param2}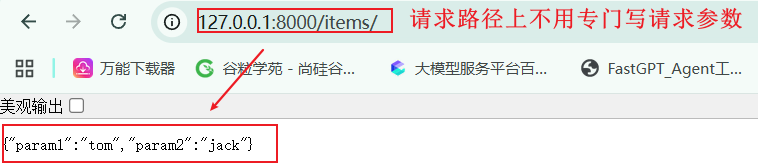
1.方式2: -> 直接在方法参数上给参数赋值为None
2.使用:
  a.请求路径上不写请求参数,请求参数就是null
  b.请求路径上写请求参数,请求参数就是具体我们赋的值
============================================================================
@app.get("/items/")
async def request_method01(param1: str = None,param2: str = None):
    return {"param1": param1, "param2": param2}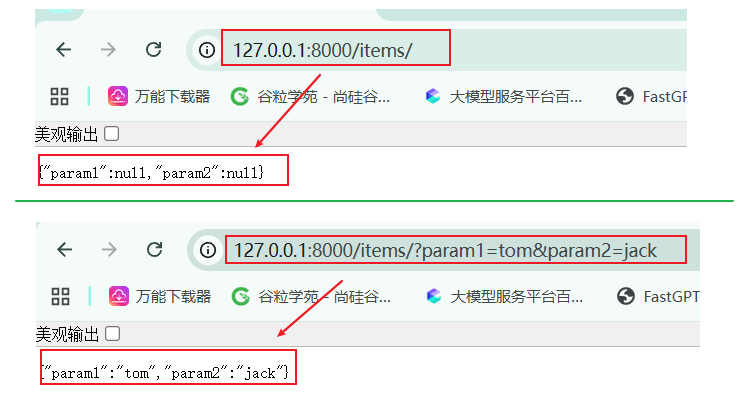
1.方式3: -> 不要给任何默认值,None也不要给
2.使用: ?param1=tom¶m2=jack
请求路径上必须要携带请求参数
============================================================================
@app.get("/items/")
async def request_method01(param1: str,param2: str):
return {"param1": param1, "param2": param2}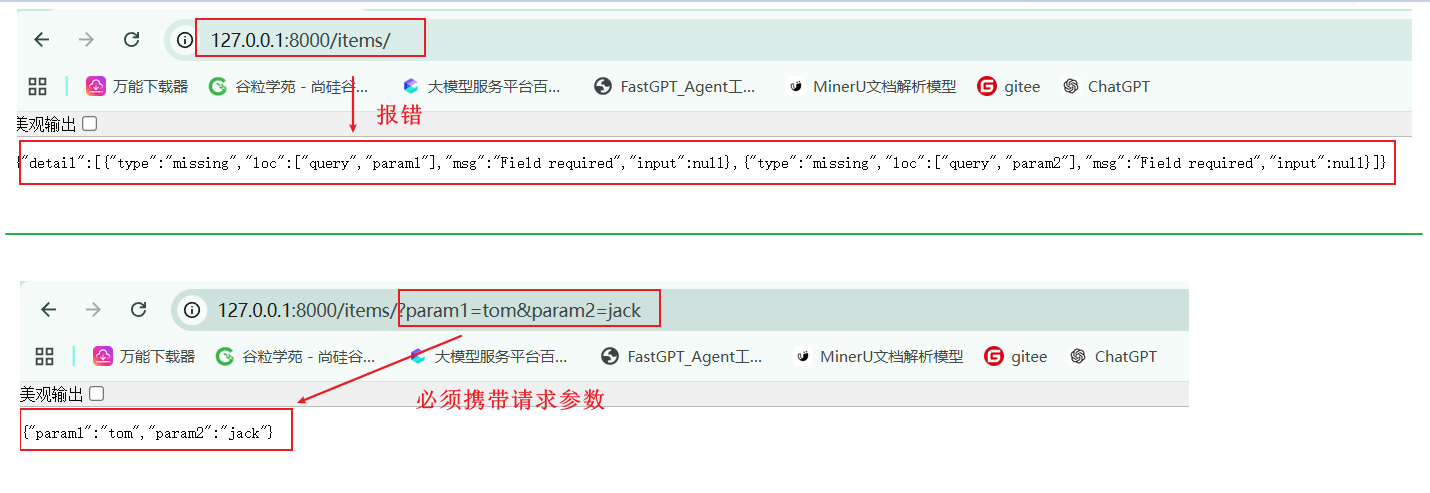
#5.4.请求体传递请求参数(了解)
1.注意:
  以上都是通过浏览器地址栏直接发送请求,地址栏发送请求都是get请求

  如果是post请求,就需要通过请求体传递请求参数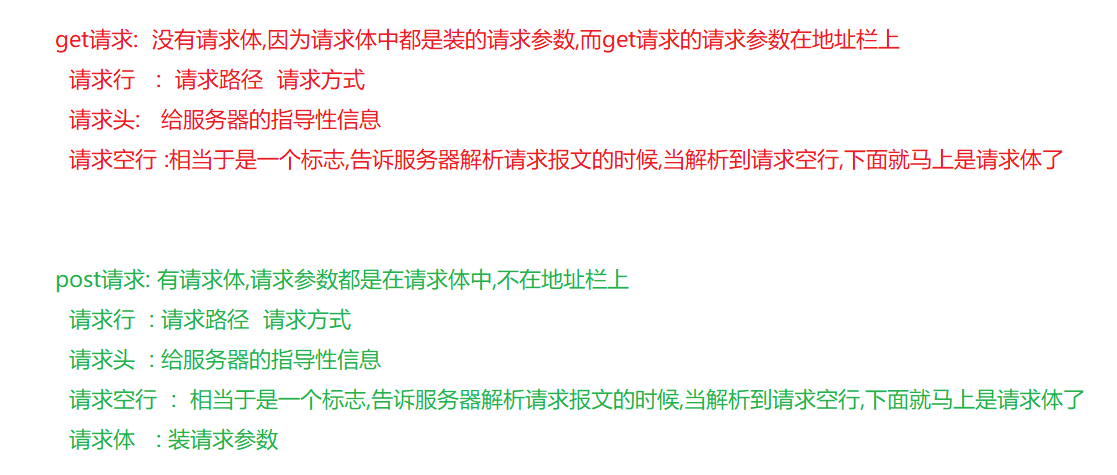
加上以下代码:
==============================================
# 定义数据模型类,需要继承 BaseModel 的类。
class Item(BaseModel):
  param1: str = None
  param2: str = None
import uvicorn
from fastapi import FastAPI
from pydantic import BaseModel
# 定义数据模型类,需要继承 BaseModel 的类。
class Item(BaseModel):
param1: str = None
param2: str = None
app = FastAPI()
@app.post("/items/")
async def request_method01(item: Item):
return item
if __name__ == "__main__":
# 直接在代码中启动uvicorn服务器
uvicorn.run(
app="demo05_fastapi:app", # 指定要运行的FastAPI应用实例
host="0.0.0.0", # 允许外部访问(本地可通过127.0.0.1或localhost访问)
port=8000, # 端口号
reload=True # 开发模式:代码修改后自动重启(生产环境需去掉)
)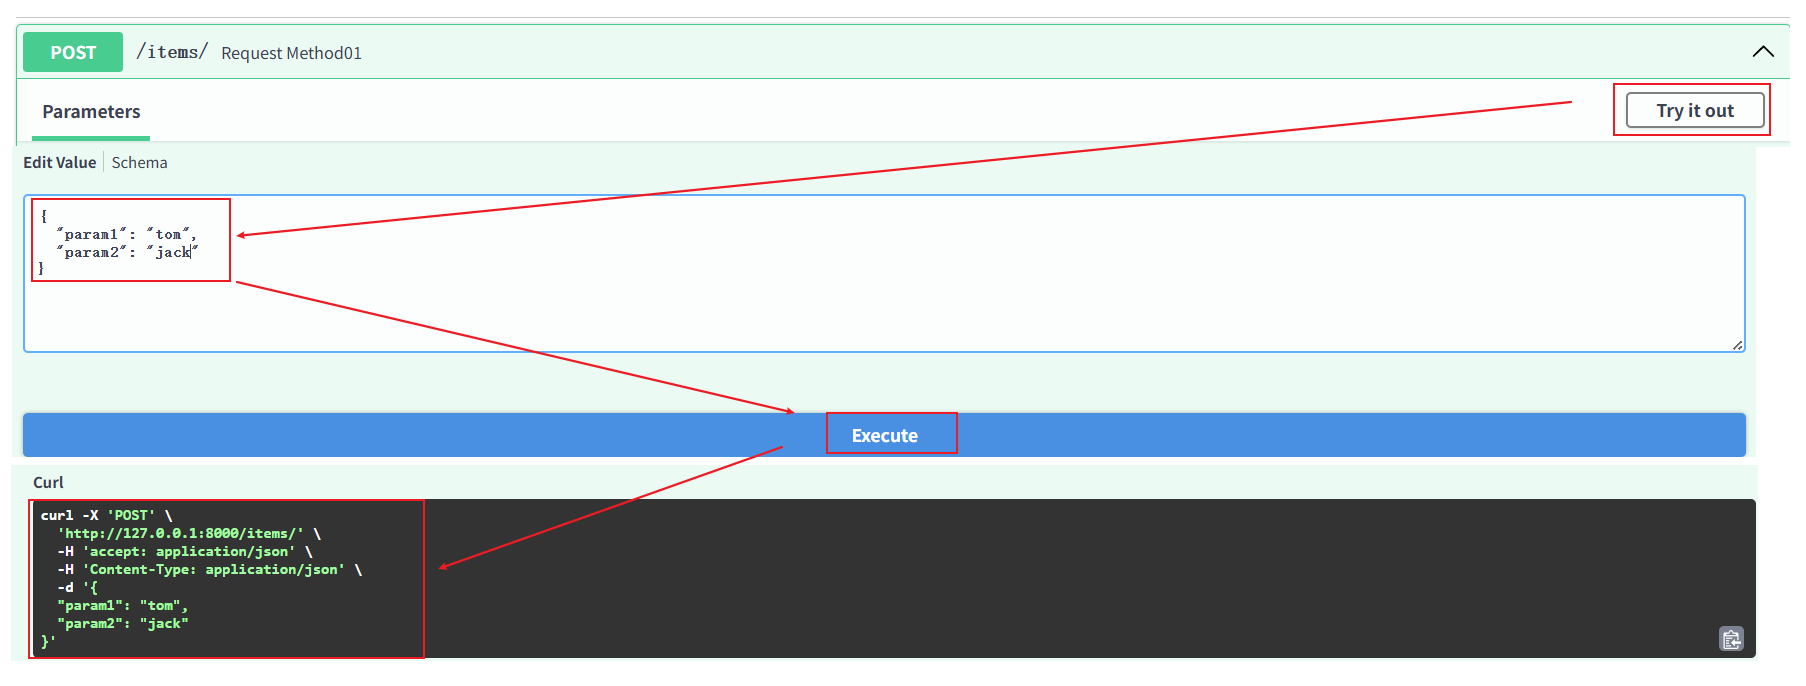
当然开发中最常用的还是用测试接口的工具直接测试,比如:PostMan
#6.路由分发
1.问题描述:
  将来我们会开发很多功能,比如我们要开发添加学生(add_student)功能,后来还要开发添加老师(add_teacher)功能,这两个功能如果放到同一个模块中就会出现很多问题:
    比如:add_student方法上的请求路径我们写成 -> @app.post("/add")
        add_teacher方法上的请求路径我们也写成了 -> @app.post("/add")

        此时这两个功能的访问路径就冲突了

2.解决:
我们将学生相关功能单独放到一个模块中,将老师相关功能单独放到一个模块中,然后将请求路径(路由)拆分放到不同的模块中#6.1.路由分发介绍
1.概述:
  当项目规模扩大时,将所有路由写在一个文件中会导致代码臃肿、难以维护。路由分发(也叫路由拆分)是将不同功能模块的路由拆分到不同文件,再通过路由注册的方式整合到主应用中,实现代码模块化。

2.核心工具:
FastAPI 中实现路由分发的核心工具是 APIRouter,它允许你在子模块中定义路由,再将其挂载到主应用#6.2.路由分发核心工具_APIRouter
1.概述:是FastAPI实现路由分发的核心工具
2.作用:在子模块中创建独立的路由集合,类似一个小型 FastAPI 应用
3.基本使用:
  a.创建APIRouter对象,由它定义路由
b.通过appinclude_router()将路由挂在到主应用上#6.3.路由分发代码实现
需求:用户模块与商品模块的路由拆分#6.3.1.项目结构
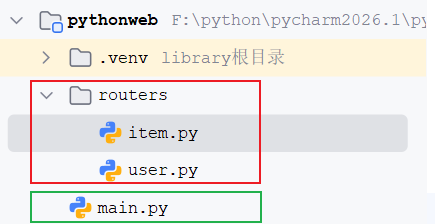
#6.3.2.开发user模块
from fastapi import APIRouter
#创建APIRouter对象,指定路由前缀(/users)
router = APIRouter(
    prefix="/users", #定义用户模块的路由前缀
    tags=["用户管理模块"]
)

@router.get("/")
async def find_all_user():
    return {"message":"查询所有用户"}


@router.get("/{user_id}")
async def find_user_by_id(user_id:int):
return {"message":f"查询用户id为{user_id}"}#6.3.3.开发item模块
from fastapi import APIRouter
#创建APIRouter对象,指定路由前缀(/users)
router = APIRouter(
    prefix="/items", #定义商品模块的路由前缀
    tags=["商品管理模块"]
)

@router.get("/")
async def find_all_items():
    return {"message":"查询所有商品"}


@router.get("/{item_id}")
async def find_items_by_id(item_id:int):
return {"message":f"查询商品id为{item_id}"}#6.3.4.开发主程序demo10_main模块_进行路由分发
from fastapi import FastAPI
from routers import item, user
import uvicorn

app = FastAPI(title="路由分发")

# 挂载用户模块的路由
app.include_router(user.router)

# 挂载商品模块的路由
app.include_router(item.router)


# 给主程序定义一个路由
@app.get("/")
async def index():
    return {"message": "欢迎访问主页面"}


if __name__ == "__main__":
    uvicorn.run(
        app="demo01_main:app",
        host="0.0.0.0",
        port=8000,
        reload=True
)#第五章.SQLAlchemy
1.概述:是操作数据库的一个框架.属于ORM工具下的其中一种
2.作用:
  a.对sql语句进行高度封装
  b.操作数据库更容易,更方便
3.最重要的核心:ORM(Object-Relational Mapping,对象关系映射) #1.ORM介绍
#1.1.ORM概述
ORM(Object-Relational Mapping,对象关系映射)是一种编程技术,它将数据库中的表结构映射为编程语言中的类,将表中的行映射为类中的对象,让开发者可以用面向对象的方式操作数据库,而无需直接编写 SQL 语句1.表名 -> 类名
2.列名 -> 属性名
3.列的类型 -> 属性的类型
4.单元格中的数据 -> 属性值
5.每一行数据 -> 类对象
a.第一行:user1 = User(1,"tom","111")
b.第二行:user2 = User(2,"jack","222")如果将表和对象对应起来,我们就不用像之前那样查询之后操作字典了,SQLAlchemy会将查询出来的数据封装成对象,然后直接根据对象中的属性名获取对应的属性值(也就是查询出来的数据)即可#1.2.ORM核心价值
1.统一不同的关系型数据库操作差异
  同一套代码可适配多种数据库(MySQL、PostgreSQL 等),无需修改核心逻辑

2.简化开发流程
  用类、对象、方法替代 SQL 语句,降低数据库操作的学习成本

3.提高代码可读性
  将数据库操作与业务逻辑融合,代码更符合面向对象思维

4.自动处理类型转换
无需手动转换数据库字段与Python类型(如MySQL的INT与Python的int) #1.3.ORM工具下的框架对比
Python生态中有多个成熟的ORM工具,各有侧重,以下是常见产品的对比| ORM工具 | 特点 | 适用场景 |
|---|---|---|
| SQLAlchemy | 功能全面,支持ORM和原生SQL,灵活度极高,文档丰富,生态完善。 | 中大型项目、复杂查询场景、需要跨数据库兼容。 |
| Django ORM | 与 Django 框架深度绑定,开箱即用,简化 CRUD 操作,但灵活性较低。 | Django 框架开发的 Web 应用。 |
| Tortoise-ORM | 异步 ORM,支持 async/await,与 FastAPI 等异步框架契合度高。 | 异步 Web 应用(如 FastAPI + 异步数据库驱动)。 |
| SQLModel | 基于 SQLAlchemy 和 Pydantic,简化模型定义,兼顾 ORM 和数据验证。 | FastAPI 项目,追求模型定义简洁性。 |
SQLAlchemy是Python中最成熟的ORM 之一,既支持简单的CRUD 操作,也能应对复杂的多表关联、事务管理等场景,且与FastAPI兼容性极佳,是生产环境的首选#2.SQLAlchemy的基本架构
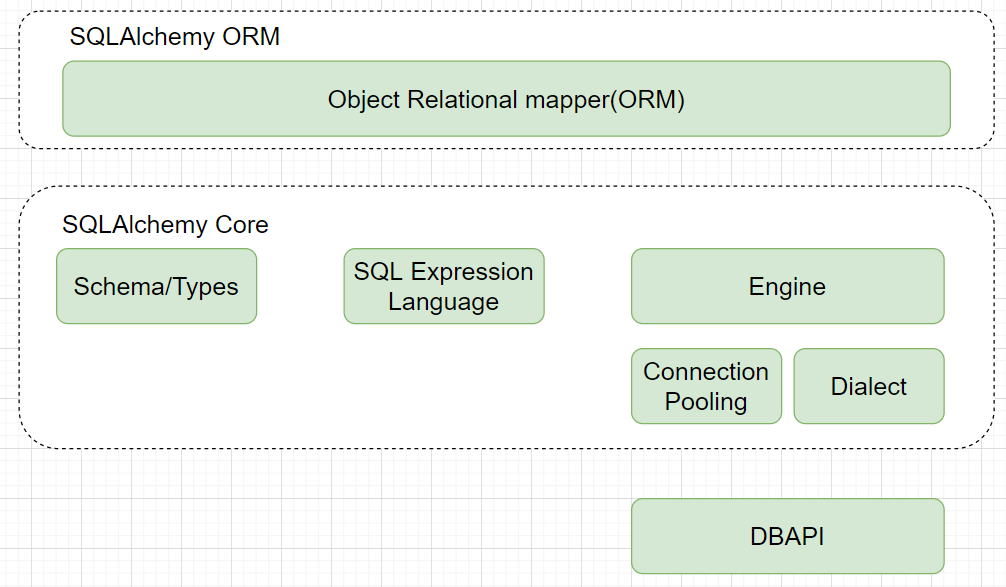
SQLAlchemy的架构分层,从下到上可分为DBAPI 层、SQLAlchemy Core(核心层)、SQLAlchemy ORM(对象关系映射层),各组件作用如下:#2.1.DBAPI(数据库通信层)
1.概述:DBAPI(Database API)是Python数据库接口规范,是SQLAlchemy与底层数据库通信的 “桥梁”。
不同数据库(如 MySQL、PostgreSQL)有各自的 DBAPI 实现(如 pymysql 是 MySQL 的 DBAPI,psycopg2 是 PostgreSQL 的 DBAPI)。SQLAlchemy 通过适配这些 DBAPI,实现对多种数据库的兼容#2.2.SQLAlchemy Core(核心层)
1.概述:Core是SQLAlchemy的 “基础工具集”,提供了SQL表达式语言、数据库连接管理等核心能力

2.组成部分:

  a.Schema / Types:定义数据库的模式(Schema)和数据类型(Types)
    Schema对应数据库的表、列、约束等结构(比如定义一张表有哪些字段、字段类型是什么)。Types封装了数据库支持的数据类型        (如 Integer、String、DateTime 等),并提供 Python 类型与数据库类型的映射。

  b.SQL Expression Language:用Python代码生成SQL语句的 “表达式语言”
    它允许你用面向对象的方式编写 SQL(比如用 table.c.column == value 表示 WHERE column = value),既保留了 SQL 的     灵活性,又能避免手写 SQL 带来的语法错误和安全问题(如 SQL 注入)

  c.Engine:管理数据库连接的 “引擎”,是与数据库交互的 “入口”
    Engine 负责创建和维护数据库连接,还会集成连接池(Connection Pooling)和方言(Dialect)

  d.Connection Pooling:管理数据库连接池,提升数据库操作性能
    连接池会预先创建一批数据库连接并复用,避免频繁创建 / 销毁连接的开销,尤其在高并发场景下能显著提高效率

  e.Dialect:处理 “方言” 差异,适配不同数据库的 SQL 语法和特性
不同数据库(如 MySQL 和 PostgreSQL)的 SQL 语法、函数可能有差异(比如 MySQL 的 LIMIT 和 PostgreSQL的 LIMIT/OFFSET 用法不同)。Dialect 会对这些差异做 “翻译”,让上层代码能以统一的方式操作不同数据库 #2.3.SQLAlchemy ORM(对象关系映射层)
1.概述:规定了表和对象的映射关系
  在Core的基础上,提供象关系映射(ORM)能力,让开发者可以用 “类和对象” 的方式操作数据库(比如用 User 类对应 users 表,用 user = User(name="Alice") 表示新增一条用户记录)。
ORM本质是对Core的 “封装”—— 它会把面向对象的操作(如创建对象、查询对象)自动转换为Core能理解的 SQL 表达式通过,最终 Engine 执行。这样开发者可以更聚焦于业务逻辑,而无需关注底层SQL实现 #2.4.核心组件
以上部分我们只需要掌握下面的内容
1.引擎(Engine)
  Engine 是与数据库的连接入口,负责管理连接池和执行 SQL 语句。
2.基类(Base)
  所有 ORM 模型的父类,用于统一管理数据库表结构。
3.会话(Session)
用于执行数据库操作的会话对象,负责暂存、提交、回滚数据操作。#3.代码实现_直接copy能看懂即可
#3.1.环境准备
#3.1.1.安装依赖
# 安装 SQLAlchemy 核心库
pip install sqlalchemy

# 安装 MySQL 驱动(推荐 pymysql,兼容 Python 3.x)
pip install pymysql#3.1.2.mysql环境
1.创建测试数据库:
CREATE DATABASE fastapi_db;#3.1.3.在base.py中定义Base基类
from sqlalchemy.ext.declarative import declarative_base

# 生成基类,所有模型需继承该类
Base = declarative_base()#3.1.4.在models.py中定义ORM模型类(映射MySQL表)
此模块中的代码可以根据类创建表from sqlalchemy import Column, Integer, String, ForeignKey, Date
from sqlalchemy.orm import relationship
from base import Base
"""
部门模型(一对多:一个部门包含多个员工)
"""
class Department(Base):
# 定义表,声明表名
__tablename__ = "departments"
#定义表中的列名以及数据类型以及约束
id = Column(Integer, primary_key=True, autoincrement=True)
name = Column(String(50), nullable=False, unique=True) # 部门名称
location = Column(String(100)) # 部门位置(如"北京总部")
# 一对多关联员工:返回员工列表,显式指定外键(可选,但更清晰)
employees = relationship(
"Employee",
back_populates="department",
# 可选:级联删除(删除部门时自动删除下属员工,根据业务选择)
# cascade="all, delete-orphan",
# 可选:懒加载策略,优化查询性能
lazy="selectin"
)
"""
员工模型(多对一:多个员工属于一个部门)
"""
class Employee(Base):
# 定义表,声明表名
__tablename__ = "employees"
# 定义表中的列名以及数据类型以及约束
id = Column(Integer, primary_key=True, autoincrement=True)
name = Column(String(50), nullable=False) # 姓名
age = Column(Integer) # 年龄
hire_date = Column(Date) # 入职日期
#添加外键约束,绑定到departments.id
department_id = Column(
Integer,
ForeignKey("departments.id", ondelete="RESTRICT"), # 禁止删除有员工的部门
nullable=False # 员工必须归属一个部门(根据业务可改为True,允许无部门)
)
# 核心修正:多对一关联,指定uselist=False(返回单个部门对象)
department = relationship(
"Department",
back_populates="employees",
lazy="joined" # 可选:立即加载部门数据,减少查询次数
)#3.1.5.在database.py创建引擎以及会话
from sqlalchemy import create_engine
from sqlalchemy.orm import sessionmaker

# MySQL 连接格式:mysql+pymysql://用户名:密码@主机地址:端口/数据库名
DATABASE_URL = "mysql+pymysql://root:root@localhost:3306/fastapi_db"

# 创建引擎(echo=True 会打印执行的 SQL,方便调试),相当于创建Connection连接
engine = create_engine(
  DATABASE_URL,
  echo=True, # 是否启用日志输出 开发环境启用,生产环境关闭
  pool_pre_ping=True # 连接前检查有效性,避免连接失效
)

# 创建会话工厂(绑定引擎),相当于创建的cursor对象,用于执行sql
SessionLocal = sessionmaker(
  autocommit=False, # 关闭自动提交,需手动 commit()
  bind=engine
)
autoflush=False :SQLAlchemy 的会话(Session)内部维护了一个 “身份映射”(Identity Map),用于缓存当前会话中操作的对象。当你执行 db.add(new_user) 时,new_user 仅被添加到这个会话内存的缓存中,并未同步到数据库(无论是缓冲区还是物理表)
#3.1.6.在main.py中提供创建表的方法并运行
运行此模块:创建表结构,通过基类的 create_all 方法在 MySQL 中创建表(仅需执行一次)from base import Base
from database import engine
from models import Employee,Department #必须要加
# 创建表
def create_table():
print("注册的表名:", Base.metadata.tables.keys())
# 创建所有模型对应的表
Base.metadata.create_all(bind=engine)
print("表创建成功")
if __name__ == '__main__':
create_table()代码中没有用到Employee,Department为啥还需要导入呢?
只有导入这两个类,才能注册到Base.metadata中,Base.metadata.create_all(bind=engine)才能为所有注册的类创建对应的表
#3.2.进行增删改查操作
#3.2.1.添加功能
#添加功能
def insert_data():
    # 获取数据库会话
    db = SessionLocal()

    try:
        # =========== 第一步:新增部门 =============
        new_dept = Department(
            name="研发部",  # 部门名称(唯一)
            location="北京总部"  # 部门位置
        )
        db.add(new_dept)  # 将部门对象加入会话
        db.commit()  # 提交到数据库(执行 INSERT 语句)
        db.refresh(new_dept)  # 刷新对象,获取自增的 id 等字段

        # =========== 第二步:新增关联的员工 ===========
        # 员工1:关联上面创建的研发部
        emp1 = Employee(
            name="张三",
            age=30,
            hire_date=date(2023, 1, 1),  # 入职日期(datetime.date 类型)
            department_id=new_dept.id  # 关联部门 ID(外键)
        )
        # 员工2:同部门的另一个员工
        emp2 = Employee(
            name="李四",
            age=28,
            hire_date=date(2023, 3, 15),
            department_id=new_dept.id
        )

        # 批量添加员工(也可逐个 add)
        db.add_all([emp1, emp2])
        db.commit()  # 提交员工数据
        # 刷新员工对象,获取自增 ID
        db.refresh(emp1)
        db.refresh(emp2)

        # ===================== 输出结果 =====================
        print(f"新增部门:ID={new_dept.id},名称={new_dept.name},位置={new_dept.location}")
        print(f"新增员工1:ID={emp1.id},姓名={emp1.name},所属部门={new_dept.name}")
        print(f"新增员工2:ID={emp2.id},姓名={emp2.name},所属部门={new_dept.name}")

        # 验证关联关系(通过 ORM 关联查询)
        print("\n【验证关联关系】")
        # 从员工查部门
        print(f"员工{emp1.name}的部门名称:{emp1.department.name}")
        # 从部门查员工
        dept_employees = new_dept.employees
        print(f"部门{new_dept.name}的员工列表:{[emp.name for emp in dept_employees]}")

    except Exception as e:
        db.rollback()  # 出错时回滚
        print(f"新增失败:{e}")
    finally:
db.close() # 关闭会话#3.2.2.删除功能
def delete_data():
    # 获取会话
    session = SessionLocal()

    try:
        # 删除单个员工
        emp = session.query(Employee).filter(Employee.name == "李四").first()
        if emp:
            session.delete(emp)
            session.commit()
            print(f"已删除员工:{emp.name}")

    except Exception as e:
        session.rollback()  # 出错时回滚
        print(f"刪除失败:{e}")
    finally:
session.close() # 关闭会话#3.2.3.修改功能
def update_data():
    # 获取会话
    session = SessionLocal()
    try:
        # 修改员工年龄
        emp = session.query(Employee).filter(Employee.name == "张三").first()
        if emp:
            emp.age = 31  # 直接修改属性
            session.commit()  # 提交更新
            print(f"修改后 {emp.name} 的年龄:{emp.age}")

    except Exception as e:
        session.rollback()  # 出错时回滚
        print(f"修改失败:{e}")
    finally:
session.close() # 关闭会话#3.2.4.查询功能
def find_data():
    # 获取会话
    session = SessionLocal()
    try:
        # ======按主键查询 get========
        #  查询id=1的部门
        dept = session.get(Department, 1)
        print(f"部门 ID=1:{dept.name}({dept.location})")

        # ======过滤(filter)查询========
        # 查询研发部的所有员工
        rd_employees = session.query(Employee).filter(
            Employee.department_id == 1  # 按部门ID过滤
        ).all()
        print("研发部员工:", [emp.name for emp in rd_employees])  # 输出:['张三']

        # 查询年龄>30的员工
        old_employees = session.query(Employee).filter(Employee.age > 30).all()
        print("年龄>30的员工:", [emp.name for emp in old_employees])  # 输出:['张三', '王五']

        # ======逻辑运算(and_/or_)查询========
        from sqlalchemy import and_, or_

        # 年龄30-40且属于研发部的员工(and_)
        emp = session.query(Employee).filter(
            and_(Employee.age.between(30, 40), Employee.department_id == 1)
        ).first()
        print("符合条件的员工:", emp.name)  # 输出:张三

        # 属于市场部或年龄>32的员工(or_)
        emps = session.query(Employee).filter(
            or_(Employee.department_id == 2, Employee.age > 32)
        ).all()
        print("符合条件的员工:", [emp.name for emp in emps])  # 输出:['张三', '王五']

        # ======表连接(join)查询========
        # 内连接:查询员工及其所属部门名称
        # 语法:query(主表, 关联表).join(关联表, 连接条件)
        result = session.query(Employee, Department).join(
            Department, Employee.department_id == Department.id
        ).all()

        for emp, dept in result:
            print(f"员工 {emp.name} 属于 {dept.name}")
        # 输出:
        # 员工 张三 属于 研发部
        # 员工 王五 属于 市场部

        # ======预加载关联数据(joinedload)查询========
        from sqlalchemy.orm import joinedload

        # 加载员工时同时加载部门信息(避免多次查询)
        employees = session.query(Employee).options(
            joinedload(Employee.department)  # 预加载关联的 department
        ).all()

        # 直接访问关联数据,不会触发新查询
        for emp in employees:
            print(f"{emp.name} 的部门:{emp.department.name}")
        # 输出:
        # 张三 的部门:研发部
        # 王五 的部门:市场部

        # ======子查询(subquery)========
        from sqlalchemy import func
        # 子查询:统计每个部门的员工数,再查询员工数>0的部门
        # 步骤1:创建子查询(统计部门员工数)
        dept_emp_count = session.query(
            Employee.department_id,
            func.count(Employee.id).label("count")  # 别名 count
        ).group_by(Employee.department_id).subquery()  # 转为子查询

        # 步骤2:主查询(关联子查询结果)
        depts = session.query(Department).join(
            dept_emp_count, Department.id == dept_emp_count.c.department_id
        ).filter(dept_emp_count.c.count > 0).all()  # 筛选员工数>0的部门

        print("有员工的部门:", [dept.name for dept in depts])  # 输出:['研发部', '市场部']

        # ======去重(distinct)========
        # 查询所有有员工的部门位置(去重)
        locations = session.query(Department.location).join(
            Employee
        ).distinct().all()  # distinct() 去重

        print("部门位置:", [loc[0] for loc in locations])  # 输出:['北京', '广州']

        # ======结果获取(first/all)========
        # first():返回第一条结果(适合唯一查询)
        first_emp = session.query(Employee).first()
        print("第一个员工:", first_emp.name)  # 输出:张三

        # all():返回所有结果(列表)
        all_depts = session.query(Department).all()
        print("所有部门:", [dept.name for dept in all_depts])  # 输出:['研发部', '市场部']

    except Exception as e:
        session.rollback()  # 出错时回滚
        print(f"查询失败:{e}")
    finally:
session.close() # 关闭会话#4.多表之间的关联关系_直接说明
在 SQLAlchemy 中,关联关系(Relationship) 用于定义不同模型(表)之间的业务关联(如一对一、一对多、多对多),通过relationship 函数实现,配合字段定义(如外键)可实现对象化的关联查询和操作#4.1.常见的关联关系
| 关联类型 | 场景示例 | 数据库实现 |
|---|---|---|
| 一对多(One-to-Many) | 一个用户拥有多个商品 | 子表通过外键关联主表 |
| 多对一(Many-to-One) | 多个商品属于一个用户 | 同上(一对多的反向视角) |
| 一对一(One-to-One) | 一个用户对应一个个人资料 | 子表外键设为唯一(unique=True) |
| 多对多(Many-to-Many) | 多个学生选修多个课程 | 通过中间表关联两个表 |
#4.2.核心配置参数(relationship 函数)
relationship 函数是定义关联关系的核心,常用参数如下| 参数 | 作用 | 示例 |
|---|---|---|
| argument | 必选,指定关联的目标模型(类或字符串) | relationship("Item") |
| back_populates | 双向关联时,指定反向关联的字段名(显式定义双向关系) | back_populates="owner" |
| backref | 简化双向关联,自动为目标模型添加反向关联字段(隐式定义) | backref="owner" |
| foreign_keys | 显式指定关联的外键字段(多外键场景下必用) | foreign_keys=[Item.owner_id] |
| cascade | 级联操作规则(如保存、删除关联数据) | cascade="all, delete-orphan" |
| lazy | 关联数据的加载方式(控制查询性能) | lazy="selectin"(一次性加载) |
| uselist | 控制是否为集合(True 表示一对多,False 表示一对一) | uselist=False(一对一) |
| secondary | 多对多关系中,指定中间表 | secondary=user_course |
| primaryjoin/secondaryjoin | 复杂关联时,显式定义表连接条件(默认自动生成) | primaryjoin=(User.id == Item.owner_id) |
#4.3.具体关联类型的配置方式_了解即可
#4.3.1.一对多与多对一
最常用的关联类型,以 “用户(User)- 商品(Item)” 为例from sqlalchemy import Column, Integer, String, ForeignKey
from sqlalchemy.orm import relationship, DeclarativeBase
class Base(DeclarativeBase):
pass
class User(Base):
__tablename__ = "users"
id = Column(Integer, primary_key=True)
username = Column(String(50))
# 一对多:用户拥有多个商品(通过 back_populates 与 Item.owner 双向关联)
items = relationship(
"Item", # 关联目标模型
back_populates="owner", # 反向关联字段(Item 中的 owner)
lazy="selectin", # 加载方式:查询用户时同时加载商品
cascade="save-update" # 级联保存:保存用户时自动保存关联商品
)
class Item(Base):
__tablename__ = "items"
id = Column(Integer, primary_key=True)
title = Column(String(100))
owner_id = Column(Integer, ForeignKey("users.id")) # 外键关联用户表
# 多对一:商品属于一个用户(反向关联)
owner = relationship(
"User", # 关联目标模型
back_populates="items" # 反向关联字段(User 中的 items)
)# 获取会话
session = SessionLocal()
# 创建用户和商品
user = User(username="test")
item = Item(title="商品1", owner=user) # 直接关联用户
user.items.append(item) # 或通过用户的 items 列表添加
session.add(user)
session.commit()
# 查询关联数据
user = session.query(User).first()
print(user.items) # 获取用户的所有商品(因 lazy="selectin" 已加载)
item = session.query(Item).first()
print(item.owner.username) # 获取商品所属用户的用户名#4.3.2.一对一
在一对多基础上,通过 uselist=False 限制关联为单个对象,以 “用户(User)- 个人资料(Profile)” 为例class Base(DeclarativeBase):
pass
class User(Base):
__tablename__ = "users"
id = Column(Integer, primary_key=True)
username = Column(String(50))
# 一对一:用户对应一个资料(uselist=False 表示非集合)
profile = relationship(
"Profile",
back_populates="user",
uselist=False, # 关键:关联结果为单个对象(非列表)
cascade="all, delete-orphan" # 删除用户时删除资料
)
class Profile(Base):
__tablename__ = "profiles"
id = Column(Integer, primary_key=True)
bio = Column(String(200)) # 个人简介
user_id = Column(Integer, ForeignKey("users.id"), unique=True) # 外键唯一
# 反向关联用户
user = relationship("User", back_populates="profile")关键点:
1.子表(Profile)的外键需设 unique=True,确保一个用户只对应一个资料;
2.主表(User)的 relationship 需设 uselist=False,表示关联结果是单个对象(而非列表)
session = SessionLocal()
# 方式1:先创建用户,再创建资料并关联
user1 = User(username="alice")
session.add(user1)
session.commit() # 先提交用户,获取 ID

profile1 = Profile(bio="喜欢读书", user_id=user1.id) # 通过 user_id 关联
session.add(profile1)
session.commit()

# 方式2:直接通过 relationship 关联(更简洁)
user2 = User(
  username="bob",
  profile=Profile(bio="热爱运动") # 直接嵌套 Profile 对象
)
session.add(user2)
session.commit() # 自动同步 user_id#4.3.3.多对多
需要通过中间表关联两个模型,以 “学生(Student)- 课程(Course)” 为例from sqlalchemy import Column, Integer, String, ForeignKey
from sqlalchemy.orm import relationship, DeclarativeBase
class Base(DeclarativeBase):
pass
from sqlalchemy import Table # 用于定义中间表
# 1. 定义中间表(无需模型类,直接用 Table 定义)
student_course = Table(
"student_course", # 中间表名
Base.metadata,
Column("student_id", Integer, ForeignKey("students.id"), primary_key=True),
Column("course_id", Integer, ForeignKey("courses.id"), primary_key=True)
)
class Student(Base):
__tablename__ = "students"
id = Column(Integer, primary_key=True)
name = Column(String(50))
# 多对多:学生选修多个课程(通过 secondary 指定中间表)
courses = relationship(
"Course",
secondary=student_course, # 关联中间表
back_populates="students",
lazy="selectin"
)
class Course(Base):
__tablename__ = "courses"
id = Column(Integer, primary_key=True)
name = Column(String(100))
# 反向关联:课程包含多个学生
students = relationship(
"Student",
secondary=student_course,
back_populates="courses"
)# 获取会话
session = SessionLocal()
# 创建学生和课程
student1 = Student(name="张三")
student2 = Student(name="李四")
course1 = Course(name="数学")
course2 = Course(name="英语")
# 建立关联
student1.courses = [course1, course2]
student2.courses = [course1]
session.add_all([student1, student2, course1, course2])
session.commit()
# 查询:学生选修的课程
print(student1.courses) # [Course(name="数学"), Course(name="英语")]
# 查询:课程包含的学生
print(course1.students) # [Student(name="张三"), Student(name="李四")]#5.sqlacodegen_通过表创建类(直接复制)
sqlacodegen 是一个实用工具,能根据现有数据库表结构(或 SQL 语句)自动生成 SQLAlchemy 模型类,省去手动编写模型类的麻烦,尤其适合已有数据库的项目迁移。
它支持多种数据库(MySQL、PostgreSQL、SQLite 等),生成的模型类包含表名、字段类型、主键、外键、索引等完整信息#5.1.安装依赖
# 直接安装(支持 SQLAlchemy 1.4+ 和 2.0+)
pip install sqlacodegen

# 如果需要连接特定数据库,需安装对应驱动(以 MySQL 为例)
pip install pymysql # MySQL 驱动#5.2.创建表
先在数据库中创建 departments(部门)和 employees(员工)表,包含一对多关系(一个部门有多个员工)-- 部门表
CREATE TABLE departments (
id INT PRIMARY KEY AUTO_INCREMENT,
`name` VARCHAR(50) NOT NULL UNIQUE COMMENT '部门名称',
location VARCHAR(100) COMMENT '部门位置',
created_at DATETIME DEFAULT CURRENT_TIMESTAMP
);
-- 员工表(关联部门)
CREATE TABLE employees (
id INT PRIMARY KEY AUTO_INCREMENT,
`name` VARCHAR(50) NOT NULL COMMENT '员工姓名',
age INT COMMENT '年龄',
hire_date DATE COMMENT '入职日期',
department_id INT COMMENT '所属部门ID',
FOREIGN KEY (department_id) REFERENCES departments(id) ON DELETE SET NULL,
INDEX idx_dept (department_id) -- 部门索引,优化查询
);#5.3.创建table_2_models.py
因为我们要根据表生成模型类,所以我们需要提前创建一个py文件出来,用于放自动生成的代码#5.4.在gen.py中进行测试
import subprocess
import sys

from sqlalchemy import create_engine
from sqlalchemy.orm import sessionmaker, Session

from table_2_models import Departments, Employees

# 创建数据库引擎
db_host = "localhost"
db_port = 3306
db_name = "fastapi_db"
db_user_name = "root"
db_password = "root"
url = f"mysql+pymysql://{db_user_name}:{db_password}@{db_host}:{db_port}/{db_name}?charset=utf8mb4"
engine = create_engine(url, echo=True)

# 配置会话工厂
engine = create_engine(url)
SessionLocal = sessionmaker(bind=engine, autocommit=False, autoflush=False)

# 生成模型类
def table_2_model(run=False):
  """将数据库表映射为Python类"""
  if not run:
    return
  output_path = "table_2_models.py"

  venv_python = sys.executable # 若PyCharm使用虚拟环境,这里会返回.venv下的python.exe
  print("当前使用的Python路径:", venv_python) # 确认输出是.venv/Scripts/python.exe

  cmd = [venv_python, "-m", "sqlacodegen", url]
  result = subprocess.run(cmd, capture_output=True, text=True, encoding="utf-8")

  # 打印执行结果(定位问题核心)
  print("=== 命令执行结果 ===")
  print(f"返回码(0=成功,非0=失败):{result.returncode}")
  print(f"标准输出:\n{result.stdout}")
  print(f"错误输出:\n{result.stderr}") # 重点看这里,会显示失败原因

  with open(output_path, "w", encoding="utf-8") as f:
    f.write(result.stdout)

# 向员工和部门表中插入数据
def insert_dept_emp():
  # 1. 创建员工对象(用关键字参数,日期转换为date类型)
  emp = Employees(
    id=100, # 显式指定参数名
    name='zs',
    age=20,
    # hire_date=date(2025, 10, 10) # 字符串转date对象
    hire_date='2025-10-10' # 字符串转date对象
  )

  # 2. 创建部门对象(关键字参数,日期转换为datetime类型)
  dept = Departments(
    id=10,
    name='研发部',
    location='北京',
    created_at='2025-10-10', # 字符串转datetime对象
    employees=[emp] # 关联员工
  )

  # 3. 插入数据库
  with Session(engine) as session:
    session.add(dept)
    try:
      session.commit()
      print(f"插入成功!部门ID:{dept.id},员工ID:{emp.id}")
    except Exception as e:
      session.rollback()
      print(f"插入失败:{e}")

if __name__ == "__main__":
  table_2_model(True)
  # insert_dept_emp()
#第六章.FastAPI和SQLAlchemy结合
创建一个fastapi_sqlalchemy.py模块import uvicorn
from fastapi import FastAPI, Depends, HTTPException
from sqlalchemy.orm import Session
from datetime import date
from table_2_models import Departments, Employees
from database import SessionLocal, engine
app = FastAPI()
# 依赖项:获取数据库会话
def get_db():
db = SessionLocal()
try:
yield db
finally:
db.close()
# 部门相关接口
@app.post("/departments/")
def create_department(name: str, location: str, db: Session = Depends(get_db)):
db_department = Departments(name=name, location=location)
db.add(db_department)
db.commit()
db.refresh(db_department)
return db_department
@app.get("/departments/")
def read_departments(db: Session = Depends(get_db)):
return db.query(Departments).all()
@app.get("/departments/{department_id}")
def read_department(department_id: int, db: Session = Depends(get_db)):
department = db.query(Departments).filter(Departments.id == department_id).first()
if not department:
raise HTTPException(status_code=404, detail="Department not found")
return department
if __name__ == "__main__":
# 直接在代码中启动uvicorn服务器
uvicorn.run(
app="fastapi_sqlalchemy:app", # 指定要运行的FastAPI应用实例
host="0.0.0.0", # 允许外部访问(本地可通过127.0.0.1或localhost访问)
port=8000, # 端口号
reload=True # 开发模式:代码修改后自动重启(生产环境需去掉)
)