分布式训练
分布式训练的核心不是“多张卡一起跑”,而是决定模型状态、计算和数据如何切分,以及何时通信。不同并行策略解决的瓶颈不同。
先看通信原语
Ring All-Reduce 将数据切成 份,经过 reduce-scatter 和 all-gather 两阶段,让每个 rank 最终得到完整聚合结果:
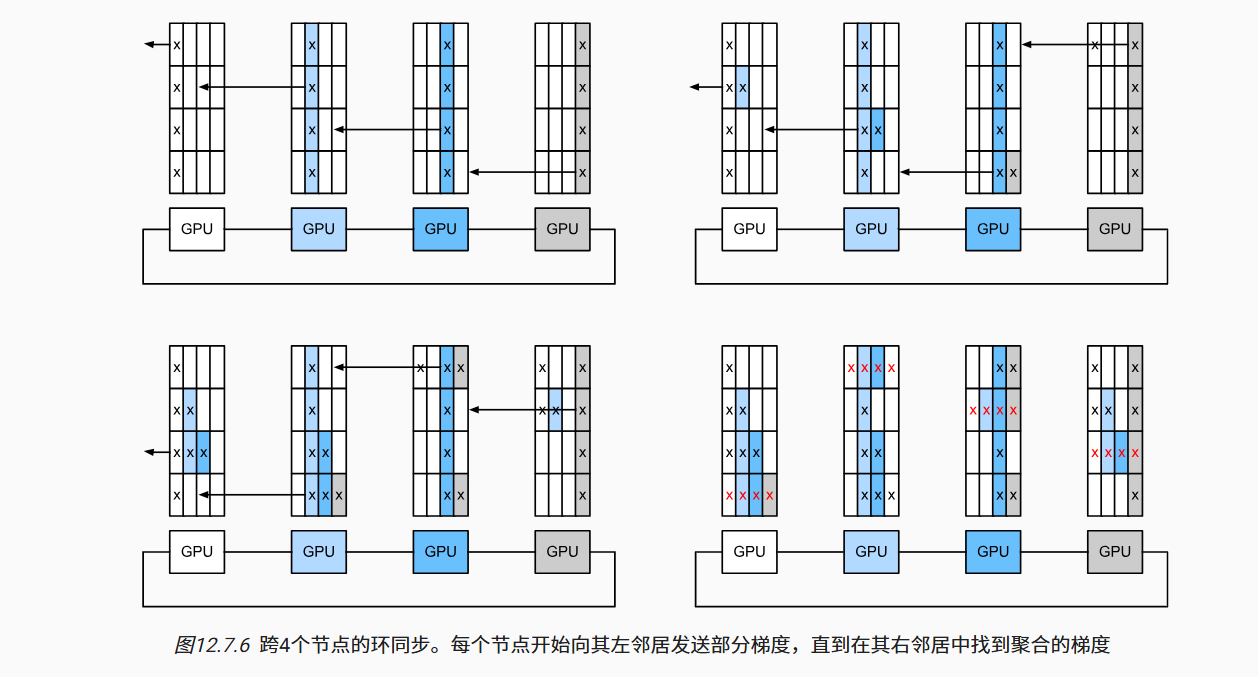
它避免单个参数服务器成为中心瓶颈,但并没有消除通信。带宽、拓扑、消息分桶和计算通信重叠会直接影响多卡扩展效率。
数据并行:DP 与 DDP
DataParallel 为什么不是首选
torch.nn.DataParallel 在单进程内把一个 batch 切到多卡,主卡负责聚合,Python 调度和主卡负担较重。PyTorch 官方长期推荐单机多卡也使用 DistributedDataParallel(DDP)。
DDP 工作过程
- 每张 GPU 对应一个进程,持有完整模型副本;
DistributedSampler给每个 rank 不同的数据;- 每个进程独立前向、反向;
- DDP 的 autograd hook 按 bucket 异步 all-reduce 梯度;
- 每个进程用相同聚合梯度更新,因此参数继续保持一致。
DDP 分摊计算与数据,不分摊模型、梯度和优化器状态。模型单卡放不下时,要转向 FSDP/ZeRO、张量并行或流水线并行。
可运行的 DDP 示例
保存为 train_ddp.py:
注意这里的 rank-0 保存规则仅适用于普通 DDP state dict;DeepSpeed 分片 checkpoint 必须所有 rank 参与。
有效 batch 和学习率
数据并行下:
把单卡改成 8 卡,如果保持每卡 batch 与累积步数不变,有效 batch 会扩大 8 倍,优化轨迹也会变化。不要把由 batch 改变带来的差异误判为“多卡算法效果”。
学习率是否线性缩放没有万能答案;预训练大 batch 常采用 scaling rule,微调小数据更应保守,用验证集比较并记录 warmup。
混合精度训练
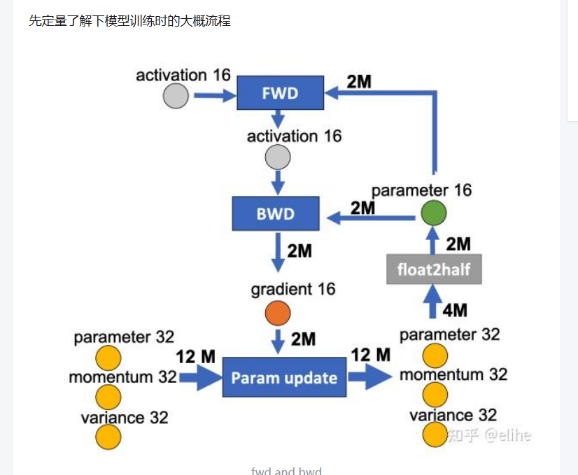
- FP16 范围较窄,通常需要 loss scaling 防止梯度下溢;
- BF16 指数范围与 FP32 接近,支持它的现代 GPU 上通常更稳;
- 优化器主状态常保留 FP32;
- 混合精度是否加速取决于 GPU 架构、算子和形状。
原生 PyTorch 自动混合精度:
BF16 通常不需要 GradScaler,但要先确认硬件支持:torch.cuda.is_bf16_supported()。
梯度检查点
普通反向传播保存大量中间激活;梯度检查点只保存部分边界,反向时重新执行缺失的前向:
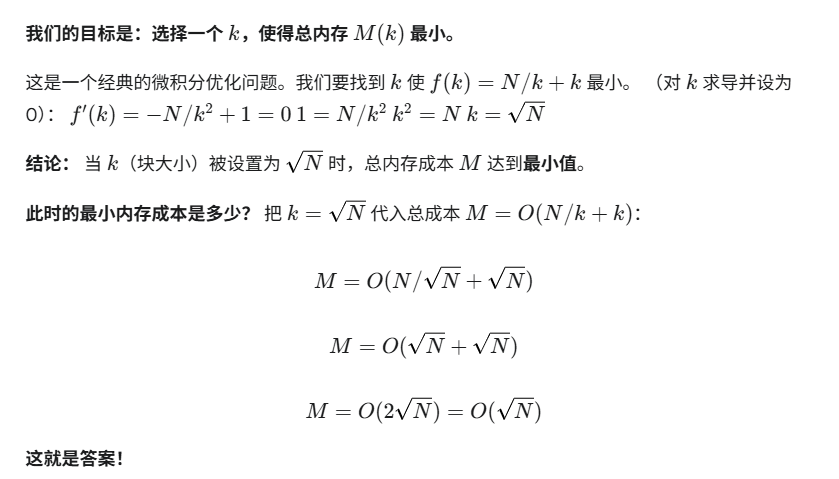
它是“用算力换显存”,主要减少激活显存,不减少参数或优化器状态。长序列训练中收益明显,但 step time 会增加。Transformer 训练常同时设置:
use_cache=False 是因为训练时 KV cache 与梯度检查点通常冲突;推理时再打开。
FSDP:在 PyTorch 内部分片模型状态
Fully Sharded Data Parallel(FSDP)与 ZeRO-3 思想接近:将参数、梯度和优化器状态分片,需要计算某层时收集参数。它更贴近 PyTorch 原生生态。
选择 FSDP 需要重点设计:
- auto-wrap policy:以 Transformer block 为边界包装,避免粒度过细;
- sharding strategy:全分片、梯度+优化器分片或 hybrid sharding;
- mixed precision:参数、reduce、buffer 的 dtype;
- activation checkpointing:与 FSDP wrap 的顺序;
- state dict 类型:full、sharded 或 distributed checkpoint;
- CPU offload:省显存但可能显著降低吞吐。
用 Accelerate 启动比手写完整包装更适合一般项目:
生产前必须演练“保存 → 新进程加载 → 推理/续训”,不能等长训练结束才第一次测试分片 checkpoint。
张量并行
张量并行(TP)把一个算子的矩阵乘分到多张卡,例如列并行或行并行线性层。每一层都会产生通信,适合模型单层/完整参数无法放入单卡、且 GPU 间高速互联的场景。
Transformer 常见切法:
- attention 头按 GPU 切分;
- MLP 中间维度切分;
- embedding / LM head 按词表维度切分;
- 通过 all-reduce 或 reduce-scatter 合并结果。
TP 对拓扑敏感,通常优先放在同一节点的 NVLink/NVSwitch 域;跨慢速网络盲目扩大 TP 会让通信淹没计算。
流水线并行
流水线并行(PP)把连续网络层分成 stages,把 mini-batch 切成 micro-batches 在流水线中流动。它减少每卡持有的层数,但有 pipeline bubble:某些 stage 等待输入或梯度时处于空闲。
stage 切分要按计算量和激活通信平衡,不能简单平均分层数。Embedding、MoE、不同宽度 block 可能让相同层数的耗时差异很大。
组合并行
超大模型通常使用 3D/4D 并行:
例如 64 张 GPU 可组成 DP=8 × TP=4 × PP=2。并行度乘积要等于 world size,但“数学上能整除”不等于性能好;还要让高频通信尽量留在高速互联域。
Accelerate:统一启动入口
训练代码使用 Accelerator 后,可在不改主体逻辑的情况下切换单卡、DDP、FSDP 和 DeepSpeed:
分布式训练时避免直接使用全局 print()、手写 .cuda() 和只在单进程正确的随机采样。用 accelerator.print()、accelerator.device、gather_for_metrics() 等封装。
多卡调试清单
正确性
- 每个 epoch 调用
DistributedSampler.set_epoch(epoch); - 只让主进程写普通日志和最终文件,但分片 checkpoint 遵守框架要求;
- 验证指标先跨 rank 聚合,避免只计算 rank 0 的数据;
- 随机种子要考虑 rank,同时保证需要一致的初始化保持一致;
- 数据长度不能让某些 rank 提前退出,导致其余 rank 卡在 collective。
性能
- 同时记录单卡和多卡 tokens/s、step time、scaling efficiency;
- 用 profiler 区分数据加载、计算、通信和同步等待;
- 检查 GPU 利用率、网络带宽、CPU 解码和存储吞吐;
- 调整梯度 bucket、micro-batch、累积与 sequence packing;
- 避免每步
.item()、打印或同步保存引入全局同步。
OOM
依次处理:异常长样本 → 序列长度 → micro-batch → 梯度检查点 → 混合精度 → QLoRA → ZeRO/FSDP → offload。发生 OOM 的 rank 常会先退出,其他 rank 最终只显示 NCCL timeout;要回看所有 rank 最早的错误。
容器和共享内存
GPU 容器至少确认 NVIDIA Container Toolkit 和 GPU 可见性。多进程 DataLoader/NCCL 还可能受共享内存限制:
生产项目不要长期追随 latest;验证后固定镜像 digest 或明确 tag,并保存驱动与主机 GPU 信息。
参考资料
- PyTorch:DistributedDataParallel
- PyTorch:FSDP
- PyTorch:Distributed Overview
- Hugging Face Accelerate
- DeepSpeed ZeRO
- 本地
knowledge-center的分布式训练、DeepSpeed、FSDP 与注意事项笔记