生成与评估
检索只是把候选证据找出来。生成阶段还要决定放哪些证据、怎样处理冲突、如何引用、何时拒答;评估则要把“看起来不错”拆成可定位、可回归的指标。
1. 上下文组装
推荐在送入模型前完成以下工作:
- 按重排分数、来源质量、时效和权限筛选;
- 用
document_id/parent_id去重,合并相邻块; - 给每段证据分配稳定编号,并保留标题、页码、URL、版本;
- 检测相互冲突的版本或数值,不要静默选一个;
- 在 Token 预算内保留最能覆盖问题各子项的证据;
- 把系统指令与外部文档严格分隔,防止文档中的提示注入成为指令。
相关性最高的片段不一定全放在最前面。可按子问题分组,或将最关键证据放在开头和结尾,降低长上下文中的位置偏差。
2. 生成 Prompt 的边界
一个可靠的回答约束至少包含:
“只能依据证据”不等于永远机械摘抄。模型可以归纳、比较和计算,但应能把结论追溯到证据;推断内容应明确标注为推断。
3. 结构化输出
下游程序往往需要 JSON、XML 或固定对象,而不是自然语言。三种常见路线:
- LangChain:
StrOutputParser、JSON Parser、Pydantic Parser; - LlamaIndex:
refine/compact响应合成、Pydantic Programs、函数调用; - 不依赖框架:在 Prompt 中给出 JSON Schema、字段说明和少量示例,再做本地校验。
仅让模型“请输出 JSON”不够。应验证 Schema,失败时进行受限重试;模型和推理引擎支持时,可用 Function Calling 或 GBNF/JSON Schema 约束解码。
4. Function Calling 的完整循环
完整流程不是模型输出一个函数名就结束:
- 应用提供工具定义与参数 Schema;
- 模型选择工具并生成参数;
- 应用校验权限与参数;
- 真实代码执行工具;
- 工具结果以独立消息返回模型;
- 模型基于结果生成最终答案。
工具输出仍是不可信数据。SQL、文件、网络或业务 API 都要执行权限、超时、大小和内容限制。
5. RAG 评估三角
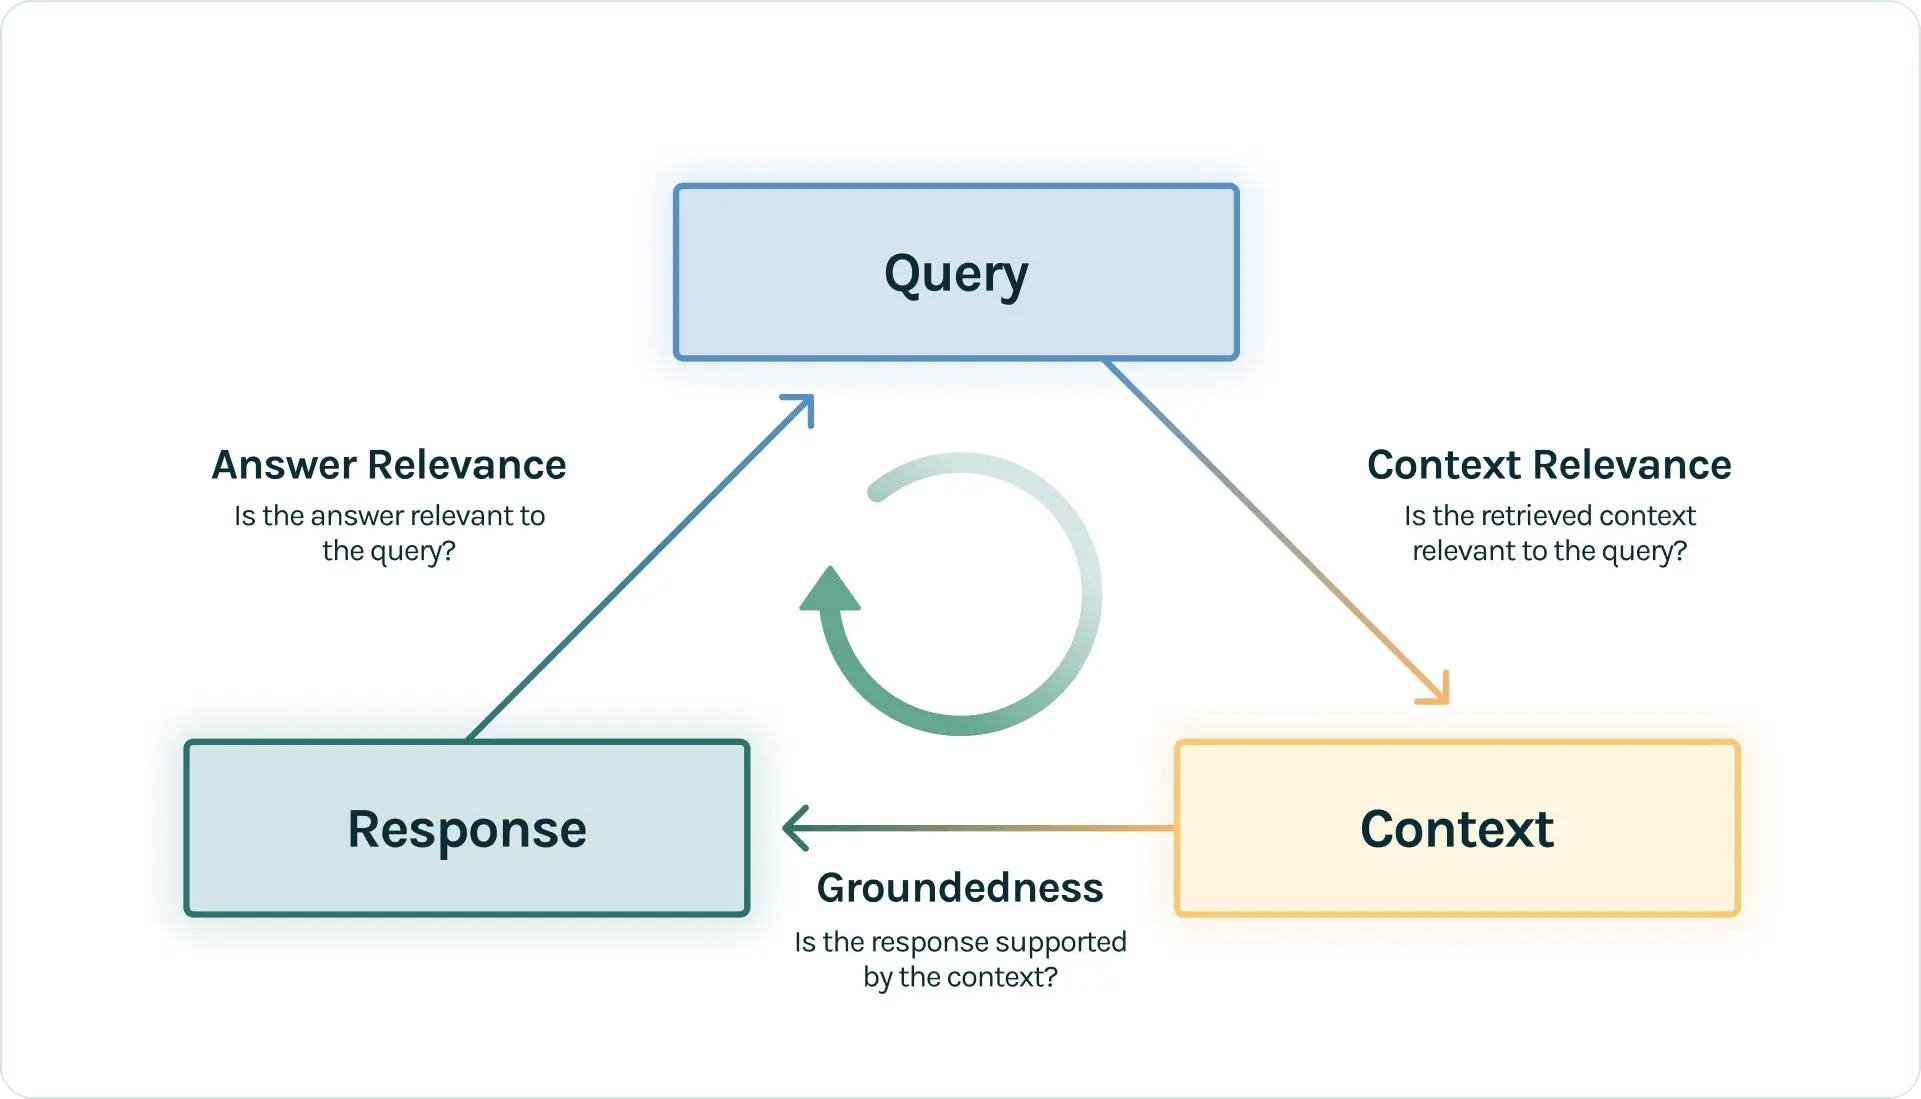
三个核心问题互相独立:
- Context Relevance:检索上下文是否与问题相关;
- Faithfulness/Groundedness:答案中的主张是否能由上下文支持;
- Answer Relevance:答案是否真正回应问题。
上下文相关但遗漏关键事实,会导致答案不完整;答案切题但不受证据支持,则是幻觉。因此不能只看一个总分。
6. 检索指标
设相关文档集合为 ,Top-k 检索结果为 :
- Precision@k:前 k 个结果有多少是相关证据;
- Recall@k:所有应找证据中找回多少;
- MRR:第一个相关结果出现得是否足够靠前;
- MAP:多个相关结果的整体排名质量;
- nDCG:有分级相关性时衡量排序质量;
- Parent/Source Recall:命中的子块是否覆盖正确父文档或来源。
标签粒度必须明确:到底标文档、页面、父块还是子块。只标最终答案而没有证据标签,无法判断检索失败还是生成失败。
7. 生成与端到端指标
7.1 LLM-as-a-Judge
可让评审模型把答案拆成原子主张,逐条检查证据支持、问题覆盖和表达质量。要固定评审 Prompt、模型版本和温度,用人工标注校准;评审模型不是绝对真值。
7.2 词面指标
ROUGE、BLEU、METEOR 适合有参考答案且措辞较稳定的任务。它们便宜可复现,但无法可靠判断语义正确、引用正确或事实是否被证据支持。
7.3 业务与系统指标
- 引用准确率、拒答准确率、冲突识别率;
- 完整解决率、人工转接率、用户纠错率;
- 首 Token、P50/P95 总延迟、检索与重排分段延迟;
- 每次请求 Token、Embedding、重排、外部搜索成本;
- 权限泄漏、提示注入、敏感信息和越权工具调用。
8. 评估数据集
一个可用集合应包含:
- 查询、期望答案或评分标准;
- 相关证据 ID、页码和版本;
- 查询类型:事实、比较、多跳、聚合、时效、无答案;
- 难例标签:别名、缩写、否定、表格、扫描件、跨文档;
- 权限和租户场景;
- 线上失败回流的真实案例。
自动生成问题可以快速扩充覆盖,但生成模型容易照抄文档措辞,使任务过于简单。应加入真实用户表达、硬负例、冲突资料和明确无答案问题。
9. 七步评估闭环
- 明确目标和不可接受的错误;
- 建立带证据标签的数据集;
- 固定数据、模型、Prompt 和参数,标准化运行;
- 保存基线;
- 按查询类型、来源、语言、长度等切片;
- 阅读坏案例并归因;
- 把修复过的案例加入回归集,在上线前比较质量、延迟和成本。
一次只改少量变量。否则即使总分提高,也不知道是切块、Embedding、Top-k、重排还是生成 Prompt 起作用。
10. 常用评估工具
- LlamaIndex Eval:数据集生成、Faithfulness/Relevancy 评估、Hit Rate/MRR 和批量评估;
- Ragas:Faithfulness、Answer Relevancy、Context Precision、Context Recall、Factual Correctness 等指标;
- Phoenix:基于 OpenTelemetry 的 Trace、评估、守护规则和可视化分析。
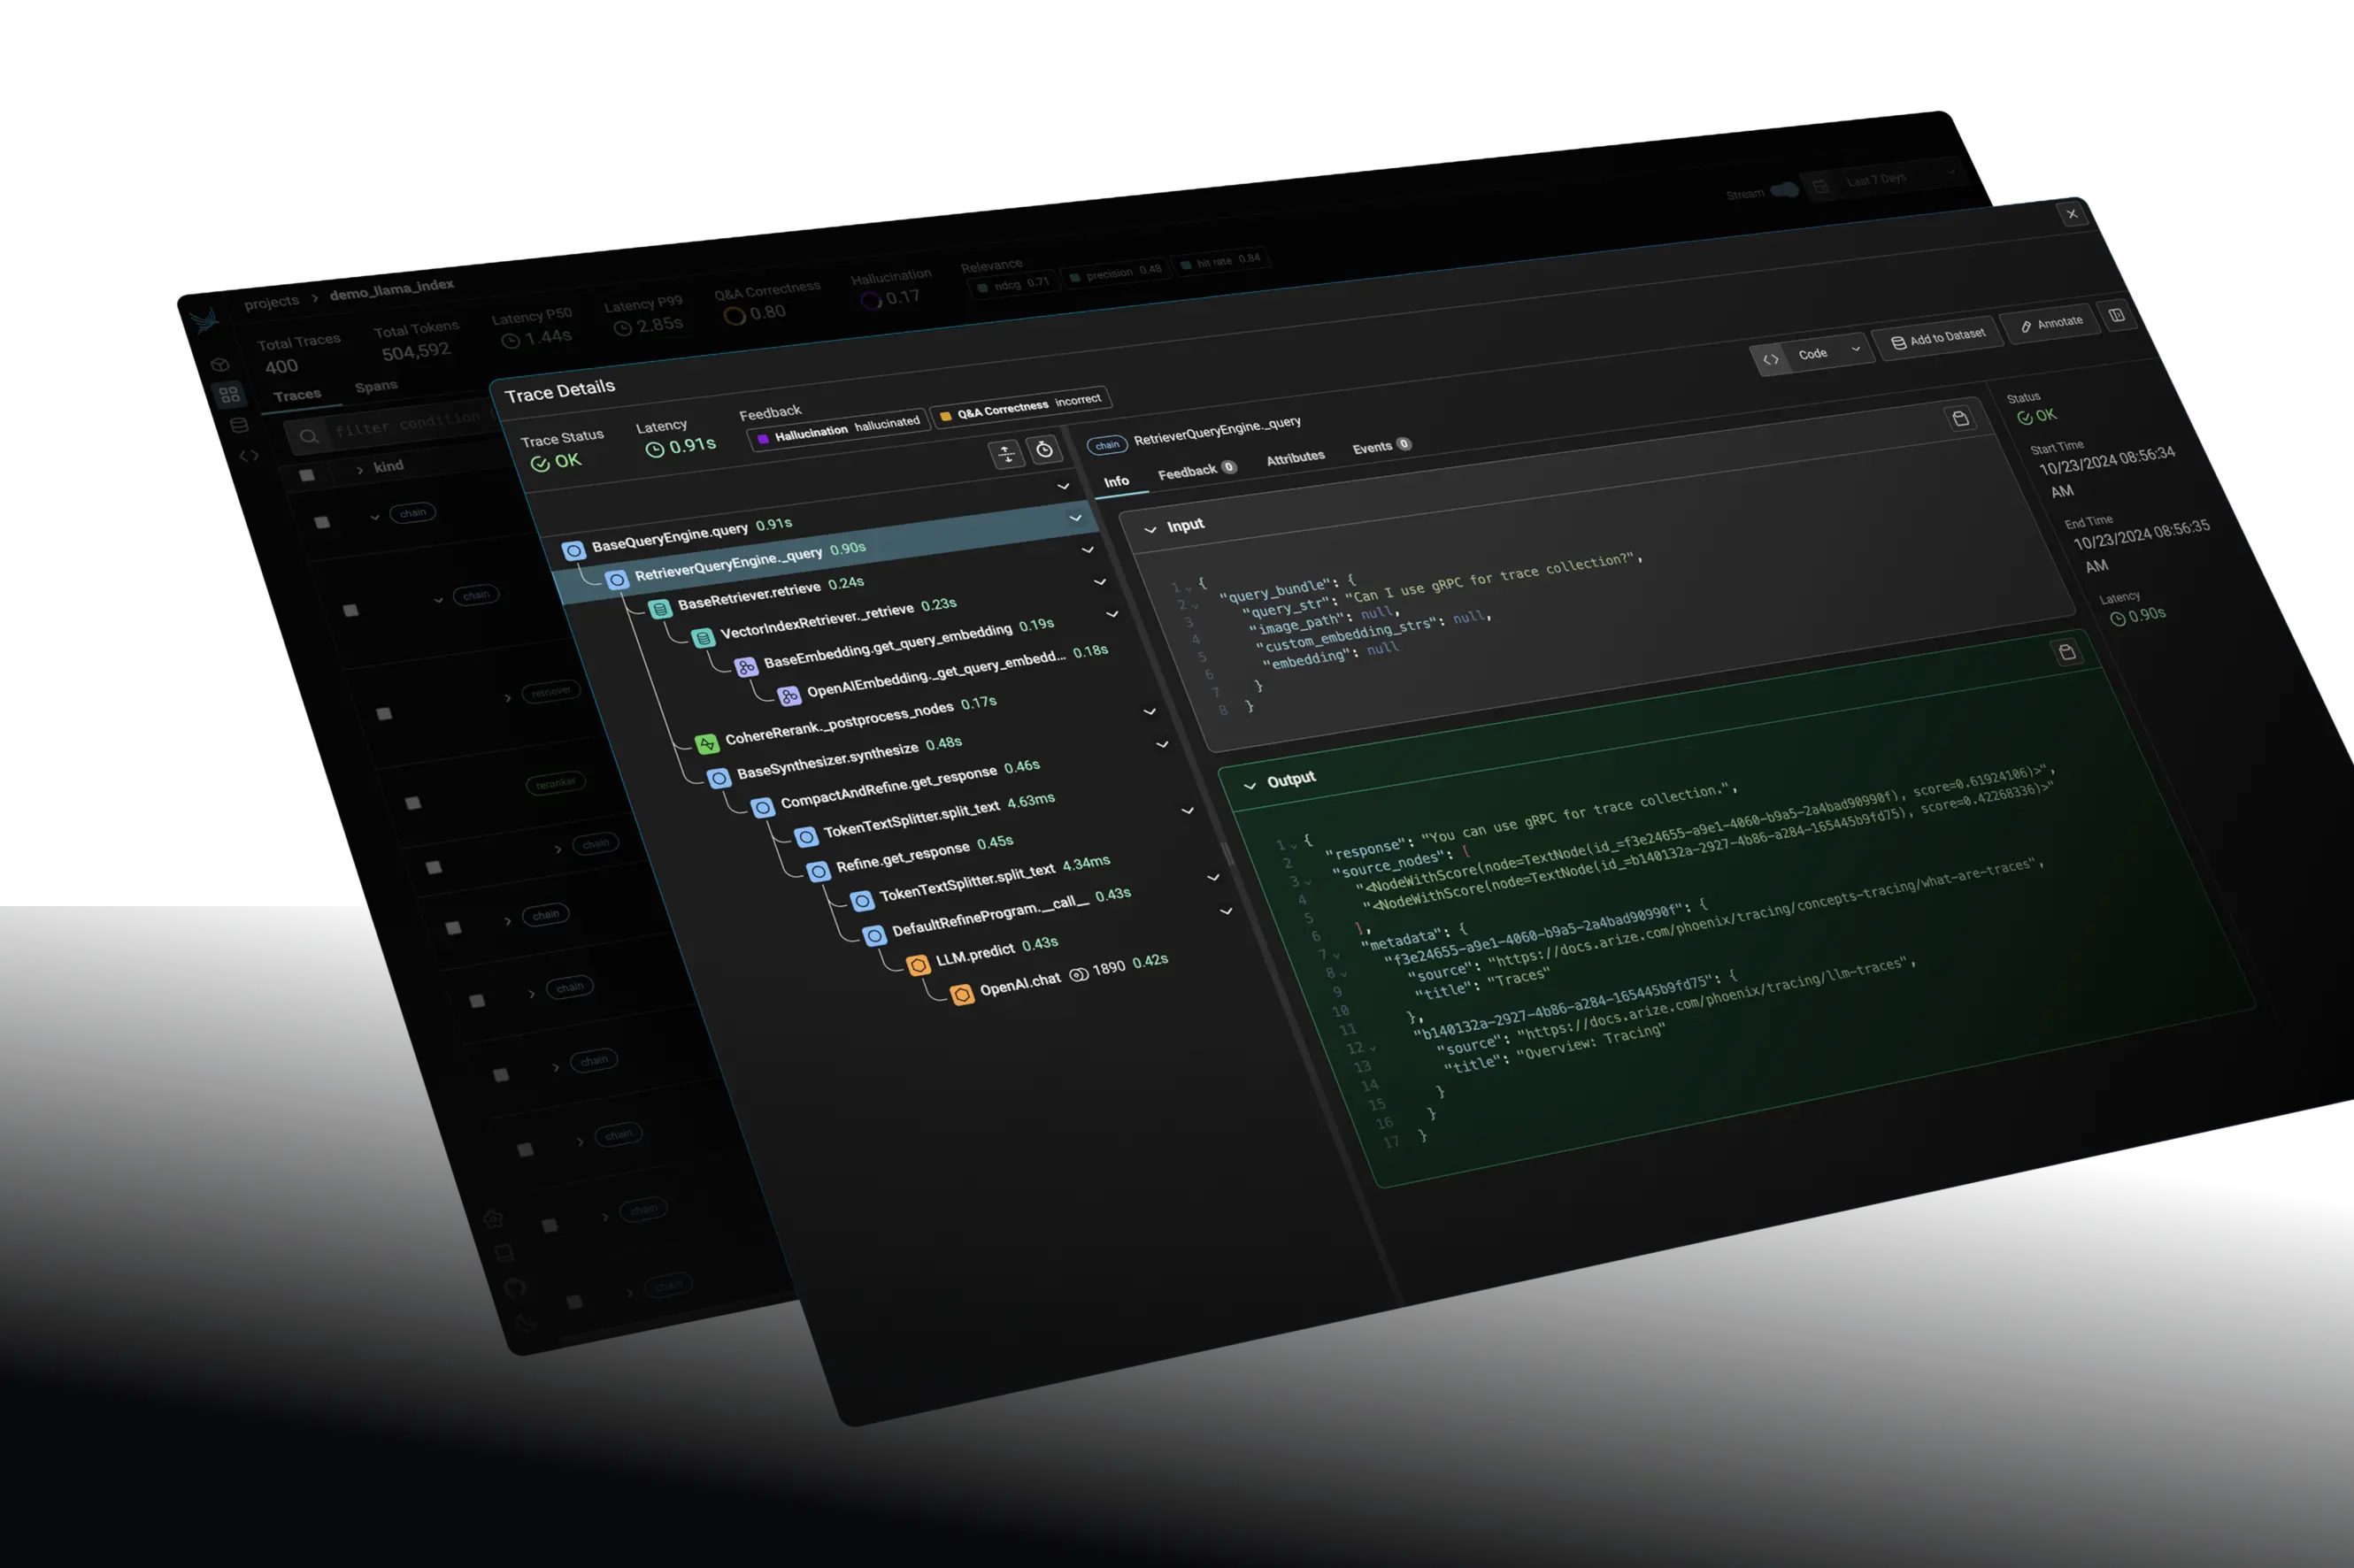
工具只提供计算框架。指标名称相同也可能因版本、评审模型和 Prompt 不同而不可直接比较,配置必须与结果一起保存。
11. 本章来源
all-in-rag/docs/chapter5/:LangChain/LlamaIndex/原生结构化生成、Function Calling 和约束解码。all-in-rag/docs/chapter6/:RAG 三角、检索/生成指标、评估闭环、LlamaIndex Eval、Ragas 与 Phoenix。knowledge-center/src/Agent/RAG.md:RAG 三角及基于评审模型的系统评估。